Sống sót qua ngày mở bán: storefront có p95 38 giây
Storefront Next.js trên ECS chạm p95 38s và 50k lỗi 5xx/phút lúc đỉnh. Cache stampede, sticky 404, socket phình vô hạn, và rig k6 chạy cùng region.
Trong bài này
Play In The Box bán merch fandom Hàn Quốc qua mở hộp gacha, raffle và các đợt drop theo chiến dịch. Drop chính là mô hình kinh doanh, và cũng là hình dạng traffic tệ nhất có thể: đang im re, rồi tất cả mọi người ùa vào cùng lúc, cùng đòi đúng vài trang.
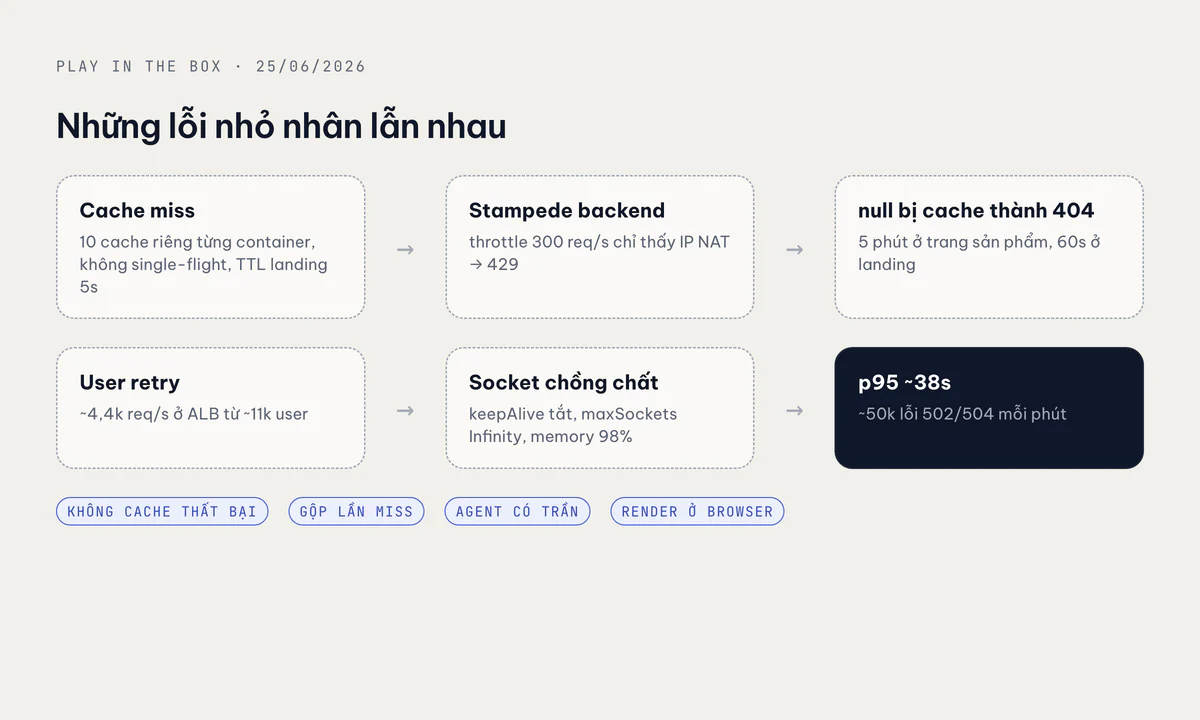
Ngày 25/06/2026 một đợt cao điểm đổ vào và frontend sập. Số liệu hôm đó theo tài liệu kiến trúc ghi lại: khoảng 4,4k request/giây ở load balancer trong khi chỉ có khoảng 11k user, p95 của frontend khoảng 38 giây, và khoảng 50k response 502/504 mỗi phút. Nhu cầu trang server-render khoảng 3k/giây. Còn fleet, mười task ECS mỗi task 2 vCPU và 2 GB chạy Next.js 16 chế độ standalone, chỉ phục vụ được đâu đó từ 500 đến 2.000.
Cái đáng chú ý là tỉ lệ giữa hai con số đầu. Bốn nghìn request mỗi giây từ mười một nghìn người nghĩa là đang có retry. Hệ thống tự đẻ ra tải cho chính nó. Bài này đi qua lý do, những gì team đã đổi, và cái rig load test mà team dựng để lần fix sau được đo trước chiến dịch chứ không phải đo ngay giữa chiến dịch.
Không có bug nào một mình
Báo cáo sự cố viết sau đó có một ý mà giờ mình sẽ đặt lên đầu mọi postmortem: không có bug đơn lẻ nào làm sập hệ thống. Đó là một cụm lỗi nhỏ ở tầng ứng dụng, lỗi nào đứng một mình cũng chịu được, nhưng chúng nhân lẫn nhau. Báo cáo cũng nói thẳng điều nó không dám khẳng định: muốn chốt một nguyên nhân gốc thì cần telemetry ngay lúc sự cố, mà có những thứ lúc đó không hề có.
Cache stampede
Storefront cache dữ liệu backend bằng unstable_cache của Next. Cache này nằm trong từng container, trên memory và đĩa local. Không có cache handler dùng chung, nên mười task sau một load balancer không sticky nghĩa là mười cache riêng, và một request chỉ có khoảng một phần mười cơ hội rơi đúng chỗ đang có entry nóng. Purge theo tag cũng chỉ tới được đúng container xử lý lệnh purge đó.
Thêm nữa, Next không gộp các request đồng thời cho cùng một entry đang thiếu. Một entry nóng hết hạn là mọi request đang bay cho nó cùng đập vào backend một lúc. Dữ liệu landing có TTL 5 giây. Và key cache có chứa ngày hiện tại, nên mọi entry trên toàn fleet cùng hết hạn lúc nửa đêm UTC.
Sticky 404
Đây là lỗi bị xếp mức nghiêm trọng, vì nó đánh vào trang sản phẩm, nơi người ta bấm mua. Khi backend trả lỗi thoáng qua hoặc một response mà code không đọc được, hàm fetch trả về null. unstable_cache lưu cái null đó như mọi giá trị khác, suốt năm phút của cache sản phẩm. Thế là một sản phẩm bình thường, còn hàng, hiện "không tồn tại" với mọi khách trong tối đa năm phút, trong khi curl thẳng vào API vẫn trả dữ liệu ngon lành. Lỗi chập chờn, khó tái hiện, giải thích cho người khác nghe rất cực.
Trang landing dính đúng bug đó ở dạng rộng hơn: mọi lỗi, kể cả 5xx, lỗi mạng hay timeout, đều thành null và bị cache 60 giây. Một cú chập một giây biến thành một phút mất trang landing cho tất cả mọi người, và ai thấy thì bấm refresh.
Socket phình không giới hạn
Phần server-side rendering gọi backend NestJS qua axios, và axios dùng global agent của Node. Trong setup này nghĩa là keepAlive: false và maxSockets: Infinity: mỗi lần gọi là một lần bắt tay TCP và TLS mới, và không có trần cho số kết nối mở cùng lúc. Gặp spike, số kết nối cứ tăng tới khi cạn file descriptor và memory. Memory của frontend chạm đỉnh 98%.
Mấy thứ khuếch đại
Vài thứ nhỏ hơn làm mọi chuyện ở trên tệ thêm:
- Một câu debug còn sót in toàn bộ response API của landing ra stdout ở mỗi lần fetch phía server.
console.loglà đồng bộ, nên lúc đỉnh nó chặn event loop, và nó ghi khoảng 185.000 bản ghi CloudWatch trong ba giờ. - Backend throttle ở 300 request/giây mỗi IP. Đứng sau NAT gateway, nó chỉ thấy IP egress của frontend, nên một giới hạn tưởng là theo user đã âm thầm thành ngân sách cho cả fleet, và phần vượt quay về dưới dạng 429.
- Timeout axios 15 giây để request chậm chồng lên nhau thay vì fail sớm.
- Root layout ép mọi trang thành dynamic vì CSP nonce, việc đọc session và một lần đọc cookie. Không phần nào của app cache được ở edge.
Những gì đã đổi
Không bao giờ cache một thất bại
Quy tắc đơn giản: cache chỉ lưu kết quả thành công. Not-found thật thì có một entry âm ngắn hạn, và các request đồng thời cho cùng key dùng chung một lần gọi backend:
const inFlight = new Map<string, Promise<Product>>();

function getProduct(key: string) {
  const pending = inFlight.get(key);
  if (pending) return pending;                // nhập vào lời gọi đang chạy

  const p = cachedFetch(key)                  // throw thay vì trả null
    .finally(() => inFlight.delete(key));
  inFlight.set(key, p);
  return p;
}
Throw thay vì trả null là chỗ mấu chốt. Lỗi bị throw thì không bao giờ được ghi vào cache. Với trang landing, ném lại lỗi thoáng qua còn có nghĩa là Next tiếp tục phục vụ bản trang tốt gần nhất trong lúc revalidate ở nền, nên user thấy nội dung hơi cũ thay vì thấy lỗi. Not-found thật được kiểm tra lại sau 15 giây thay vì năm phút.
TTL của landing tăng từ 5 lên 60 giây, nội dung sửa vẫn lên trong vòng một phút. Footer settings, hoá ra chiếm khoảng 35% tổng request vào backend, được cache riêng. Build production giờ strip hết console.log, info và debug.
Đặt trần cho socket
Mọi lời gọi phía server giờ đi qua một agent có keep-alive và có trần:
const agent = new https.Agent({
  keepAlive: true,
  keepAliveMsecs: 15_000,
  maxSockets: Number(process.env.API_MAX_SOCKETS ?? 64), // mỗi task
  maxFreeSockets: 16,
  scheduling: 'lifo',
});
Sáu mươi tư socket mỗi task, nhân mười task, là một cái trần biết trước cho số kết nối frontend có thể mở vào backend. Request vượt trần thì xếp hàng trong queue của Node thay vì mở thêm kết nối mới.
Render ở browser
Tài liệu kiến trúc mình viết đề xuất phục vụ storefront công khai từ CDN edge, với s-maxage và stale-while-revalidate theo từng loại trang, cache key gồm path, locale và thị trường, và chỉ cache response 200. Muốn vậy thì root layout phải thôi ép render dynamic. Team đã làm phần tách đó, đo, rồi revert. Static shell chỉ biến được mấy trang ít giá trị thành tĩnh, trong khi lại đẩy trang sản phẩm và trang collection quay về dynamic. Còn cái thay đổi duy nhất có thể làm mấy trang đó tĩnh thì không an toàn, vì nó sẽ nướng sẵn giá của thị trường mặc định và header ở trạng thái chưa đăng nhập vào HTML được cache.
Thứ thực sự được ship, trong hai ngày 26 và 27/06, là chuyển phần thân của trang home, landing, gacha, raffle và catalog sang render ở browser, gọi API trực tiếp. Tài liệu nói thẳng headroom đến từ đâu: "from the render offload, not from caching". Phần CloudFront thực sự được ship là một image CDN với TTL dài đứng trước ảnh sản phẩm.
Mình nghĩ chuyện này đáng nói ra. Thiết kế mình tâm đắc nhất lại không phải là thứ mang lại kết quả.
Scale theo đúng tín hiệu
Phía hạ tầng, các service ECS có policy target-tracking theo CPU (target 60%), theo số request ALB trên mỗi target, và theo memory của frontend, với cooldown scale-out 60 giây và scale-in 300 giây. Backend nâng mức tối thiểu lên 4 task, tối đa 10, task frontend từ 2 GB lên 4 GB, và Redis chuyển sang ElastiCache.
Bốn ngày sau sự cố đầu tiên có sự cố thứ hai, một vòng xoáy chết vì health check, và được xác nhận rõ là không phải OOM. Dưới tải nặng, server rendering bị giới hạn bởi CPU. Cân bằng kiểu round-robin để một task nóng rực trong khi CPU trung bình của service vẫn thấp, health check của nó quá hạn, ECS giết một task đang bận nhưng vẫn sống, và tải dồn sang task kế tiếp. Cách sửa là đổi load balancer sang least_outstanding_requests, timeout health check 10 giây với ngưỡng unhealthy là 5, và làm nóng sẵn số task tối thiểu trước chiến dịch. Runbook tóm lại bằng một câu mình hay nhớ: số task khoẻ không có nghĩa là hiệu năng khoẻ.
Rig load test đặt ngay cạnh server
Load test từ laptop là đang đo mạng của cái laptop. Team dựng rig trong cùng AWS region với production: một cluster EKS tạo bằng eksctl, ba node spot c5.2xlarge, round trip tới target khoảng 1 ms. k6-operator chạy test với 8 runner song song, mỗi runner đỉnh 400 request/giây, tổng khoảng 3.200 RPS.
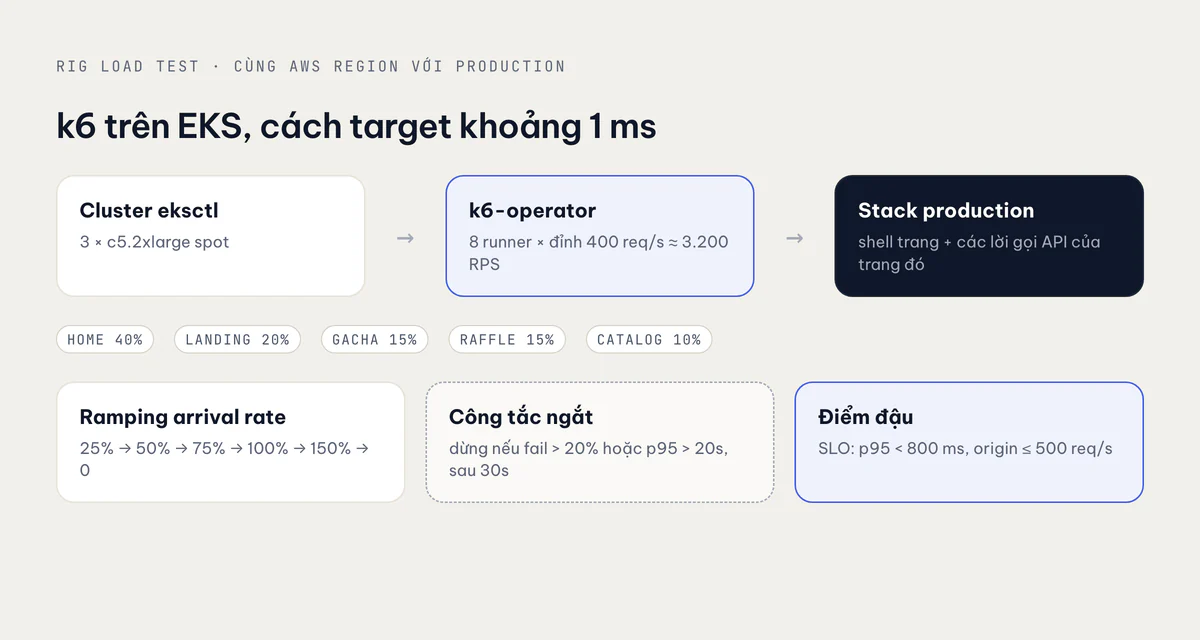
Kịch bản dùng ramping arrival rate chứ không cố định số virtual user, vì một đợt drop được định nghĩa bằng lượng người đến:
export const options = {
  scenarios: {
    drop: {
      executor: 'ramping-arrival-rate',
      preAllocatedVUs: Math.max(100, PEAK),
      maxVUs: PEAK * 6,
      stages: [
        { target: PEAK * 0.25, duration: '30s' },
        { target: PEAK * 0.5,  duration: '1m'  },
        { target: PEAK * 0.75, duration: '1m'  },
        { target: PEAK,        duration: '2m'  },
        { target: PEAK * 1.5,  duration: '1m'  },
        { target: 0,           duration: '30s' },
      ],
    },
  },
  thresholds: {
    http_req_failed:   [{ threshold: 'rate<0.20', abortOnFail: true, delayAbortEval: '30s' }],
    http_req_duration: [{ threshold: 'p(95)<20000', abortOnFail: true, delayAbortEval: '30s' }],
  },
};
Mỗi iteration là một hành trình thật: shell của trang cộng các lời gọi API mà trang đó thực hiện, chia trọng số 40% home, 20% landing, 15% gacha, 15% raffle và 10% catalog. Counter riêng tách response thành 200, 429, 5xx, 502/503/504 và timeout, vì "lỗi tăng" chẳng nói lên gì cho tới khi biết là loại lỗi nào.
Các threshold ở đây là công tắc ngắt chứ không phải điểm đậu. Test chạy vào stack production thật, nên nếu hơn 20% request fail hoặc p95 vượt 20 giây thì nó tự dừng sau 30 giây ân hạn. Điểm đậu nằm trong bảng SLO của tài liệu thiết kế: p95 dưới 800 ms, origin dưới 500 request/giây, 5xx coi như bằng không.
Lần sau mình vẫn sẽ làm
- Lấy số request chia cho số user. Request rate cao hơn hẳn mức mà số user giải thích được nghĩa là hệ thống đang tự sinh tải.
- Không bao giờ cache
null. Lỗi thì throw để cache không lưu được, not-found thật thì cho TTL âm ngắn. - Gộp các lần miss. Cache riêng từng container mà không có single-flight thì lần hết hạn nào cũng thành stampede.
- Đừng nhét ngày vào cache key trừ khi muốn cả fleet hết hạn lúc nửa đêm.
- Gắn HTTP agent cho mọi client phía server. Keep-alive cộng
maxSockets, tính theo sức backend. - Kiểm tra rate limit của backend thực sự nhìn thấy gì. Sau NAT, theo IP có thể là theo cả fleet.
- Strip debug log khỏi build production. Log đồng bộ là một bộ nhân tải.
- Load test từ trong region, dùng kịch bản arrival rate, hành trình thật, và ngưỡng abort.
- Sẵn sàng bỏ thiết kế mình thích nhất. Đo nó, rồi ship cái thực sự kéo được con số.
Thêm về nền tảng và vai trò của mình ở đó trong case study Play In The Box.
Bài liên quan