Encoder livestream 24/7: failover, fencing và scale từ số 0
Cách một nền tảng livestream YouTube 24/7 giữ stream sống khi encoder chết: fencing bằng epoch, failover cẩn thận, kế hoạch KEDA 0 đến 50 pod, upload 10GB.
Trong bài này
Mảng livestream của Wavesgroup làm một việc nghe rất đơn giản: lấy video khách upload lên và giữ nó phát liên tục trên một buổi live YouTube, cả ngày lẫn đêm. Gần như mọi buổi live trên nền tảng đều là 24/7. Mỗi encoder chạy một process ffmpeg, đẩy một file, phát lặp, vào một RTMP key.
Cái đơn giản kết thúc ngay lần đầu một encoder chết. Không ai nhận stream thì YouTube kết thúc broadcast và buổi live của khách mất luôn. Hai encoder cùng nhận thì cả hai cùng đẩy vào một key và stream hỏng theo kiểu khác. Phần lớn công sức với hệ thống này dồn vào đúng khoảng hở đó: phát hiện encoder chết cho nhanh, mà không nhầm một database chậm thành cả fleet chết, và đảm bảo lúc nào cũng chỉ đúng một encoder đang đẩy.
Bài này đi qua thiết kế ownership và failover đang chạy hiện tại, phần setup Kubernetes và KEDA mà hệ thống đang được chuyển sang, và luồng upload có resume nạp file tới 10 GB cho nó.
Một pod, một ffmpeg, một buổi live
Encoder được giữ đơn giản có chủ đích. Một process sở hữu một buổi live:
ffmpeg -re -stream_loop -1 -i media.mp4 \
  -c:v copy -c:a copy -f flv "rtmp://<ingest>/<stream-key>"
Copy mode nghĩa là không transcode, nên một node rẻ vẫn gánh được stream. Nhưng chỉ chạy khi file đã được nắn sẵn cho live: render service ép keyframe interval cố định và audio AAC 48 kHz stereo cho output, vì ở copy mode trong file có gì thì lên sóng y như vậy. Khi stream resume sau một lần chuyển giao, lệnh seek đặt ở phía input (-ss trước -i). Seek ở phía output trong copy mode cho ra đúng không frame nào. Giữa các file, hoặc trong lúc encoder thay thế đang khởi động, encoder đẩy một stream đen dự phòng để RTMP key không bị chết.
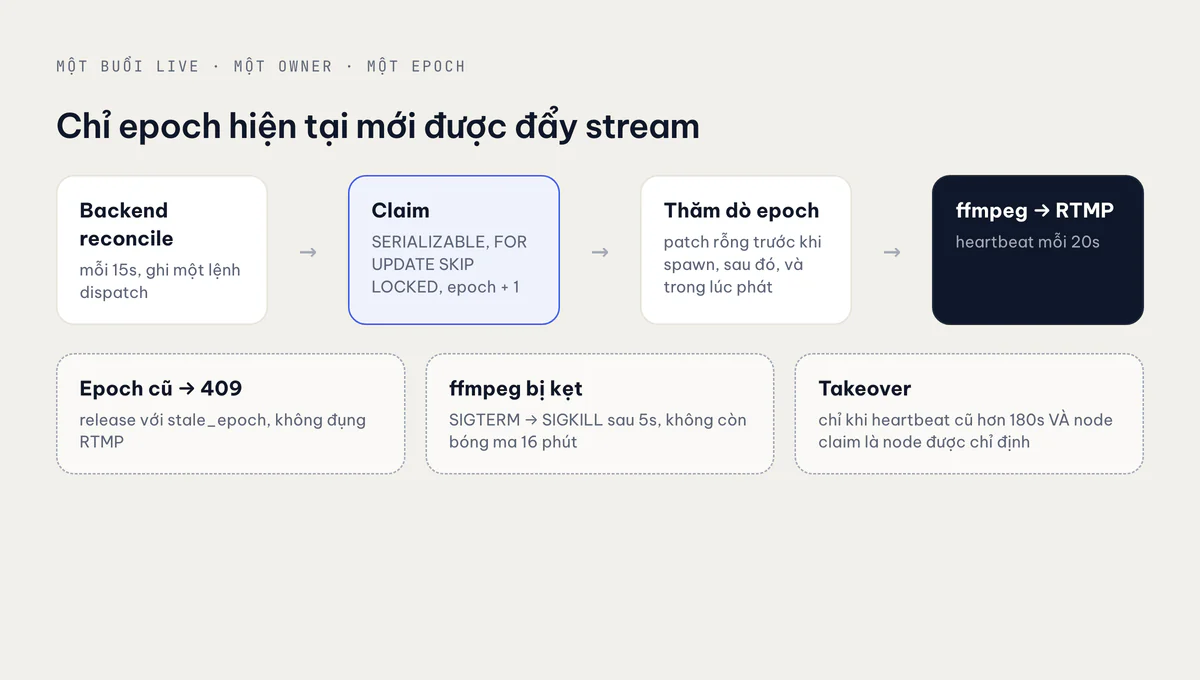
Job tới encoder theo kiểu push, không qua queue dùng chung. Backend chạy một vòng reconcile mỗi 15 giây, chọn encoder cho từng buổi live cần, rồi ghi một lệnh dispatch. Encoder poll lệnh của mình mỗi 3 giây rồi claim job.
Ownership: owner, epoch, heartbeat
Bản đầu dùng lease kiểu kinh điển: một dòng có thời hạn, gia hạn vài giây một lần dưới advisory lock của Postgres, sống 6 giây. Nó chạy ổn khi encoder nói chuyện thẳng với database. Khi encoder chuyển ra sau API của backend, ownership thành ba field trên dòng job:
owner_node: encoder nào đang giữ buổi live.owner_epoch: fencing token chỉ có tăng, không bao giờ giảm.last_heartbeat_at: owner làm mới mỗi 20 giây.
Claim chạy trong transaction serializable với FOR UPDATE SKIP LOCKED, và giành quyền từ một owner khác được làm cho khó có chủ đích:
-- trong một transaction SERIALIZABLE
SELECT owner_node, owner_epoch, last_heartbeat_at
FROM encoder_jobs WHERE id = $1 FOR UPDATE SKIP LOCKED;

-- có owner khác? từ chối (409) trừ khi heartbeat của nó cũ hơn 180s
-- VÀ node đang claim là node backend chỉ định

UPDATE encoder_jobs
SET owner_node = $me, owner_epoch = owner_epoch + 1, last_heartbeat_at = now()
WHERE id = $1;
Quy tắc đó sinh ra từ sự cố ngày 29/07/2026: một owner restart xong cứ nhận 409 mãi, vì không có gì cho phép ai giành buổi live từ một node không còn tồn tại. Hai điều kiện đi cùng nhau cho một lần takeover thật đi qua, nhưng không cho hai node đang khoẻ đua nhau.
Fencing ở phía encoder
Epoch chỉ có ích khi encoder chịu kiểm tra nó. Ngay trước khi spawn ffmpeg, encoder gửi một state patch rỗng kèm epoch của mình. Nhận 409 nghĩa là đã có người mới hơn sở hữu buổi live, nên nó release với lý do stale_epoch và không đụng tới RTMP. Nó lặp lại phép thăm dò đó ngay sau khi spawn và định kỳ trong lúc phát.
Đường kill quan trọng không kém. Ngày 06/07/2026 một vụ split-brain giết một buổi live: một process ffmpeg bị kẹt trên một RTMP socket đã chết, phớt lờ SIGTERM và tiếp tục đẩy khoảng 16 phút trong khi encoder khác đang sở hữu stream. Giờ thì SIGTERM leo thang thành SIGKILL sau 5 giây.
Failover mà không báo động giả
Phát hiện encoder chết thì dễ. Khó là không "phát hiện" ra những encoder chưa chết, và phần lớn các lớp chặn trong vòng sweep tồn tại vì một ngày tồi tệ cụ thể:
- Heartbeat bị coi là cũ sau 60 giây, và phải cũ hai vòng sweep liên tiếp mới failover, tổng cộng khoảng 75 giây. Một "zombie" có heartbeat vẫn nhảy nhưng phát thì đứng yên cần ba vòng.
- Ngày 30/06/2026 một sự cố database làm mọi heartbeat cùng trông như cũ, và vòng sweep failover luôn những buổi live đang khoẻ. Giờ nếu chính câu query tìm ghost mất hơn 2 giây, vòng sweep cho database 120 giây ân hạn.
- Nếu có ít nhất ba buổi live và ít nhất một nửa trong số đó cùng cũ một lúc, vòng sweep coi đó là sự cố của backend hoặc database chứ không phải cả fleet chết, và không làm gì cả.
- Sau khi backend restart có 120 giây ân hạn lúc khởi động, và mỗi buổi live tối đa ba lần failover.
Bản thân failover có một thứ tự quan trọng:
- Từ chối nếu session đã kết thúc.
- Gửi
cancelcho node cũ. - Đưa job về trạng thái ready, xoá owner nhưng giữ nguyên epoch, và ghi lại vị trí cần phát tiếp.
- Nếu heartbeat VM của node cũ chưa quá 30 giây, tức node vẫn còn sống, thì chờ tối đa 8 giây cho nó buông, poll mỗi 500 ms.
- Dispatch sang bất kỳ node nào trừ node cũ.
Bước 3 được viết như vậy vì hai lần sai riêng biệt. Có lần reset epoch đã làm hỏng fencing, vì token của encoder cũ lại thành hợp lệ. Còn xoá last_heartbeat_at lúc failover thì gây ra một cơn bão failover: encoder thay thế trông như đã cũ ngay lúc vừa claim, nên nó cũng bị failover, cứ thế tiếp diễn.
Chuyển sang Kubernetes với KEDA
Cập nhật, tháng 10/2026: kế hoạch này sau đó đã được bỏ. Fleet encoder giờ mở rộng bằng cách thêm các VPS thuê ngoài qua một luồng tự phục vụ trong trang admin: backend kiểm tra từng máy qua SSH, chia số encoder theo CPU rồi triển khai. Thiết kế ownership và failover ở trên vẫn giữ nguyên. Phần kế hoạch bên dưới được giữ như lúc viết.
Hiện tại encoder chạy trên một fleet VM cloud, mỗi VM có số slot cố định, và fleet đã đầy. Việc chuyển sang Kubernetes đã được chuẩn bị sẵn trong repo dưới dạng manifest. Lúc viết bài này cluster chưa được dựng, và mảnh duy nhất đã chạy trên production là demand endpoint mà KEDA sẽ đọc.
Ba quyết định định hình setup này:
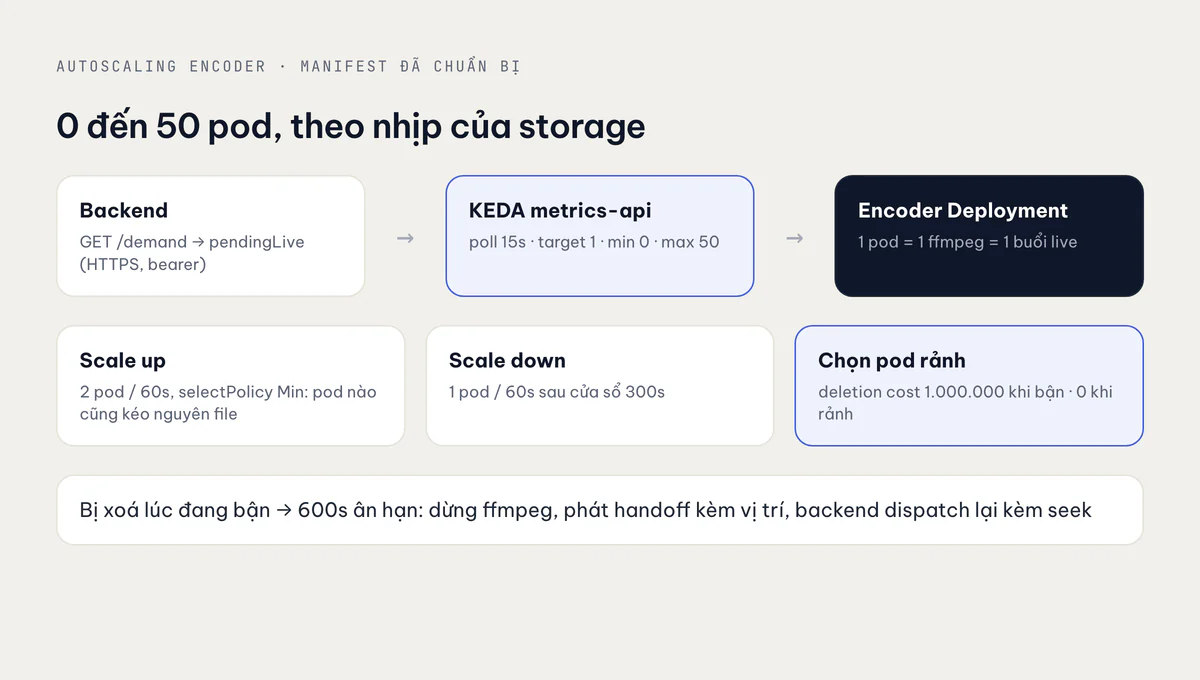
Scale theo nhu cầu do backend báo, không theo queue. Redis scaler của KEDA là lựa chọn hiển nhiên, nhưng KEDA chạy ở một mạng riêng và không với tới Redis hay Postgres private. Nên backend expose pendingLive, số buổi live đang chờ encoder, qua HTTPS, và KEDA poll nó bằng trigger metrics-api: minReplicaCount: 0, maxReplicaCount: 50, poll mỗi 15 giây, target là 1.
Giới hạn scale-up 2 pod mỗi phút. Mặc định của HPA là nhân đôi số pod hoặc thêm bốn pod mỗi 15 giây. Pod encoder mới nào cũng phải kéo nguyên file media từ object storage về rồi mới lên sóng được, mà trên 290 file đã cache thì median là 0,89 GB, p90 là 1,73 GB và file lớn nhất 8,03 GB. Tầng storage vốn đã là nút cổ chai. Ngày 21/09/2026, các encoder đồng loạt tải lại file trong một cơn bão failover đã làm đầy đĩa node, có node sinh 64 file tải dở trong hai phút. Nên scale-up bị chặn trần, kèm selectPolicy: Min để một policy thêm vào sau này không lặng lẽ nới nó ra.
Để scale-down chọn đúng pod rảnh. Mỗi encoder tự patch annotation controller.kubernetes.io/pod-deletion-cost của pod mình, 1.000.000 khi đang stream và 0 khi rảnh, mỗi 30 giây. Scale-down giới hạn một pod mỗi phút sau cửa sổ 5 phút. Nếu một pod đang bận vẫn bị xoá, nó có 600 giây ân hạn: dừng ffmpeg, phát một event handoff kèm vị trí đang phát, và backend dispatch lại buổi live với lệnh seek.
Còn một câu hỏi mình muốn trả lời trên cluster thật trước khi coi phần autoscaling là xong. pendingLive chỉ đếm những buổi live chưa được claim, nên một khi mọi buổi đã có encoder thì metric tụt dần về 0, trong khi các pod vẫn đang bận. Deletion cost và đường handoff bảo vệ stream nếu HPA có scale in, nhưng cách sửa đúng có lẽ là một con số nhu cầu đếm cả các buổi live đang chạy.
Upload tới 10 GB mà vẫn sống qua mạng chập chờn
Khách upload media từ browser thẳng lên object storage, và có người đang dùng đường truyền chậm, hay rớt. Luồng upload là multipart kiểu S3 với presigned URL:
- Session. Backend tạo một dòng media ở trạng thái pending. File nhỏ dùng một presigned PUT. File lớn hơn thì mở multipart upload, và mọi URL của các part được presign sẵn từ đầu với hạn 12 giờ, vì một file 10 GB trên đường truyền chậm mất lâu hơn rất nhiều so với một URL 15 phút.
- Part size: 6 MB. Trước đây là 50 MB, chọn theo một giới hạn CDN mà giờ không còn nằm trên đường upload nữa. Với throughput khách báo lại, một part 50 MB hỏng giữa chừng là khoảng 80 giây phải làm lại, còn part 6 MB khoảng 10 giây. File 10 GB thành 1.707 part, còn xa mới chạm trần 10.000.
- Resume. Browser lưu
{mediaId, uploadId}vàolocalStoragedưới một fingerprint gồm tên, kích thước và thời điểm sửa cuối, giữ 24 giờ. Khi thử lại, backend liệt kê các part storage đã có rồi presign lại phần còn lại, và client chỉ upload phần thiếu:
const saved = loadResume(fingerprint(file));
if (saved) {
  try {
    const { uploadedParts, urls } = await api.resume(saved.uploadId);
    await uploadParts(file, urls, { skip: uploadedParts });
    return api.complete(saved.mediaId);
  } catch (e) {
    if (isGone(e)) clearResume(fingerprint(file)); // hết hạn: làm lại từ đầu
    else throw e;
  }
}- Truyền. Bốn part chạy song song, mỗi part retry ba lần với exponential backoff có jitter bắt đầu từ 500 ms, và lỗi 503 thì tôn trọng
Retry-After. Một watchdog 30 giây bắt các upload đứng im mà không báo lỗi. Storage phải expose headerETagqua CORS, không thì client không complete được upload. - Dọn dẹp. Một lifecycle rule của bucket huỷ các multipart upload dang dở sau hai ngày.
Một cái bẫy: đổi part size là làm hỏng mọi upload đang dở, vì resume tính offset của từng part theo part size hiện tại. Hãy rollout lúc không có ai đang upload.
Lần sau mình vẫn sẽ làm
- Mỗi stream một process. Ownership, metric và lỗi đều hiện ra rõ ràng.
- Fencing bằng epoch, và worker phải tự kiểm tra trước và trong lúc tạo side effect, chứ không chỉ lúc claim.
- Leo thang SIGTERM thành SIGKILL. Một process kẹt trên socket chết sẽ sống lâu hơn lease của bạn.
- Không bao giờ reset epoch hay heartbeat lúc failover. Cả hai lỗi đó đều từng gây sự cố thật.
- Canh chừng chính bộ phát hiện. Hai vòng sweep cũ liên tiếp, ân hạn khi database chậm, và một phép kiểm tra trên toàn fleet giúp một database chậm không failover tất cả mọi người.
- Giới hạn scale-up theo sức storage nạp, và dùng pod deletion cost để scale-down xoá pod rảnh.
- Part multipart nhỏ, URL sống lâu hơn cả lần upload, resume bằng list-parts, và một lifecycle rule để dọn dẹp.
Toàn cảnh nền tảng, gồm cả order engine SMM và SSO dùng chung, nằm trong case study Wavesgroup.
Bài liên quan